실제 농업 통화에서 상용 API를 이기는 음성인식
고객사 통화의 1%로 학습했습니다. 나머지 99%가 로드맵입니다.
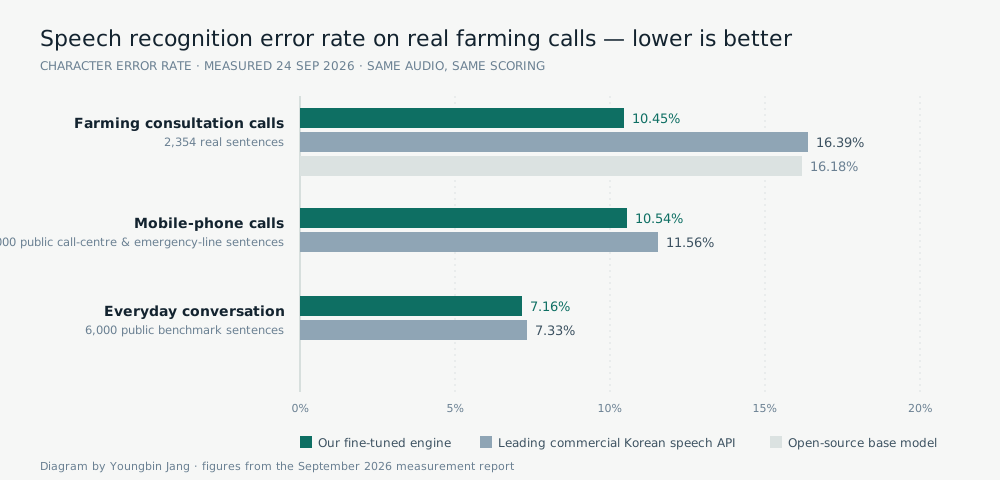
컨설턴트의 전화 통화가 영농일지와 컨설팅 보고서가 됩니다. 실제 농업 통화에서 파인튜닝한 엔진은 글자 오류 10.45%, 국내 1위 상용 음성 API는 16.39%입니다.
- 농업 통화10.45% CER · 상용 API 16.39% · 기본 모델 16.18%
- 일상 대화7.16% · 상용 API 7.33%. 잃은 것 없음
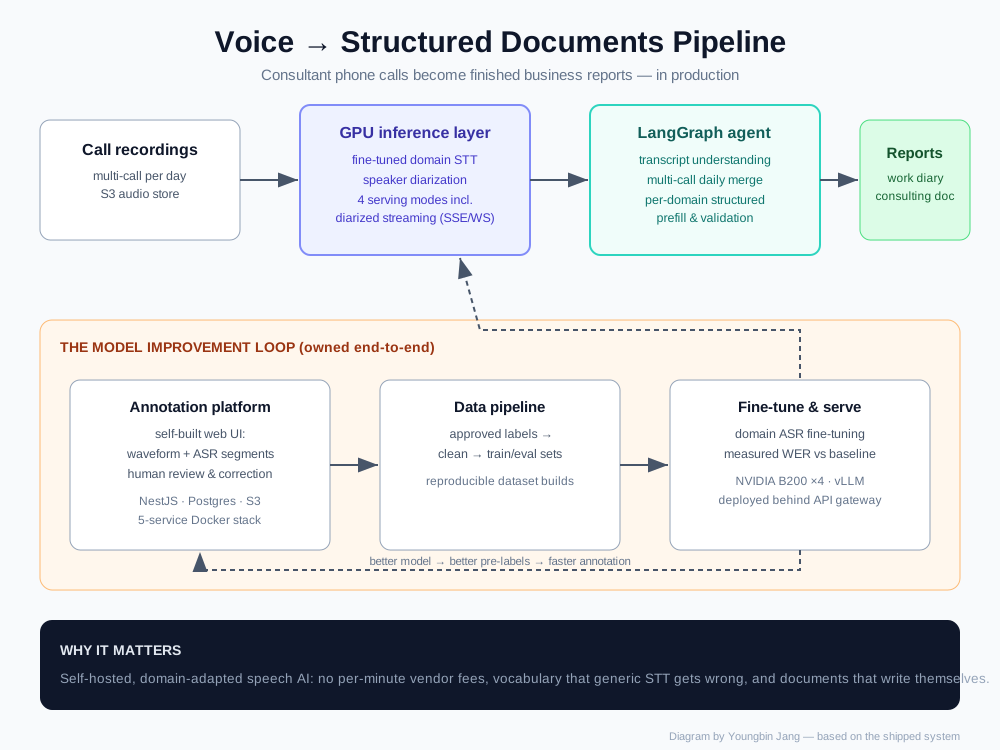
- 학습 데이터검토한 약 14,000시간 중 약 1,300시간 선별, + 고객사 통화 471건
- 서빙B200 4장, vLLM, 배치 / 스트리밍 / 화자 분리
필요했던 것
컨설턴트는 하루 종일 농민과 전화합니다. 그 통화에 영농일지와 상담 보고서에 들어가야 할 사실이 있습니다. 그런데 범용 음성인식은 작물명, 농약명, 상표명, 지역 용어를 엉망으로 받아 적었고, 사용자는 전사 결과를 믿지 않게 됐습니다. 기성 엔진은 뉴스와 스튜디오 대화에서 점수를 잘 받도록 학습되어 있습니다. 휴대전화로 하는 농업 통화에 맞춰 최적화하는 곳은 없습니다.
만든 것
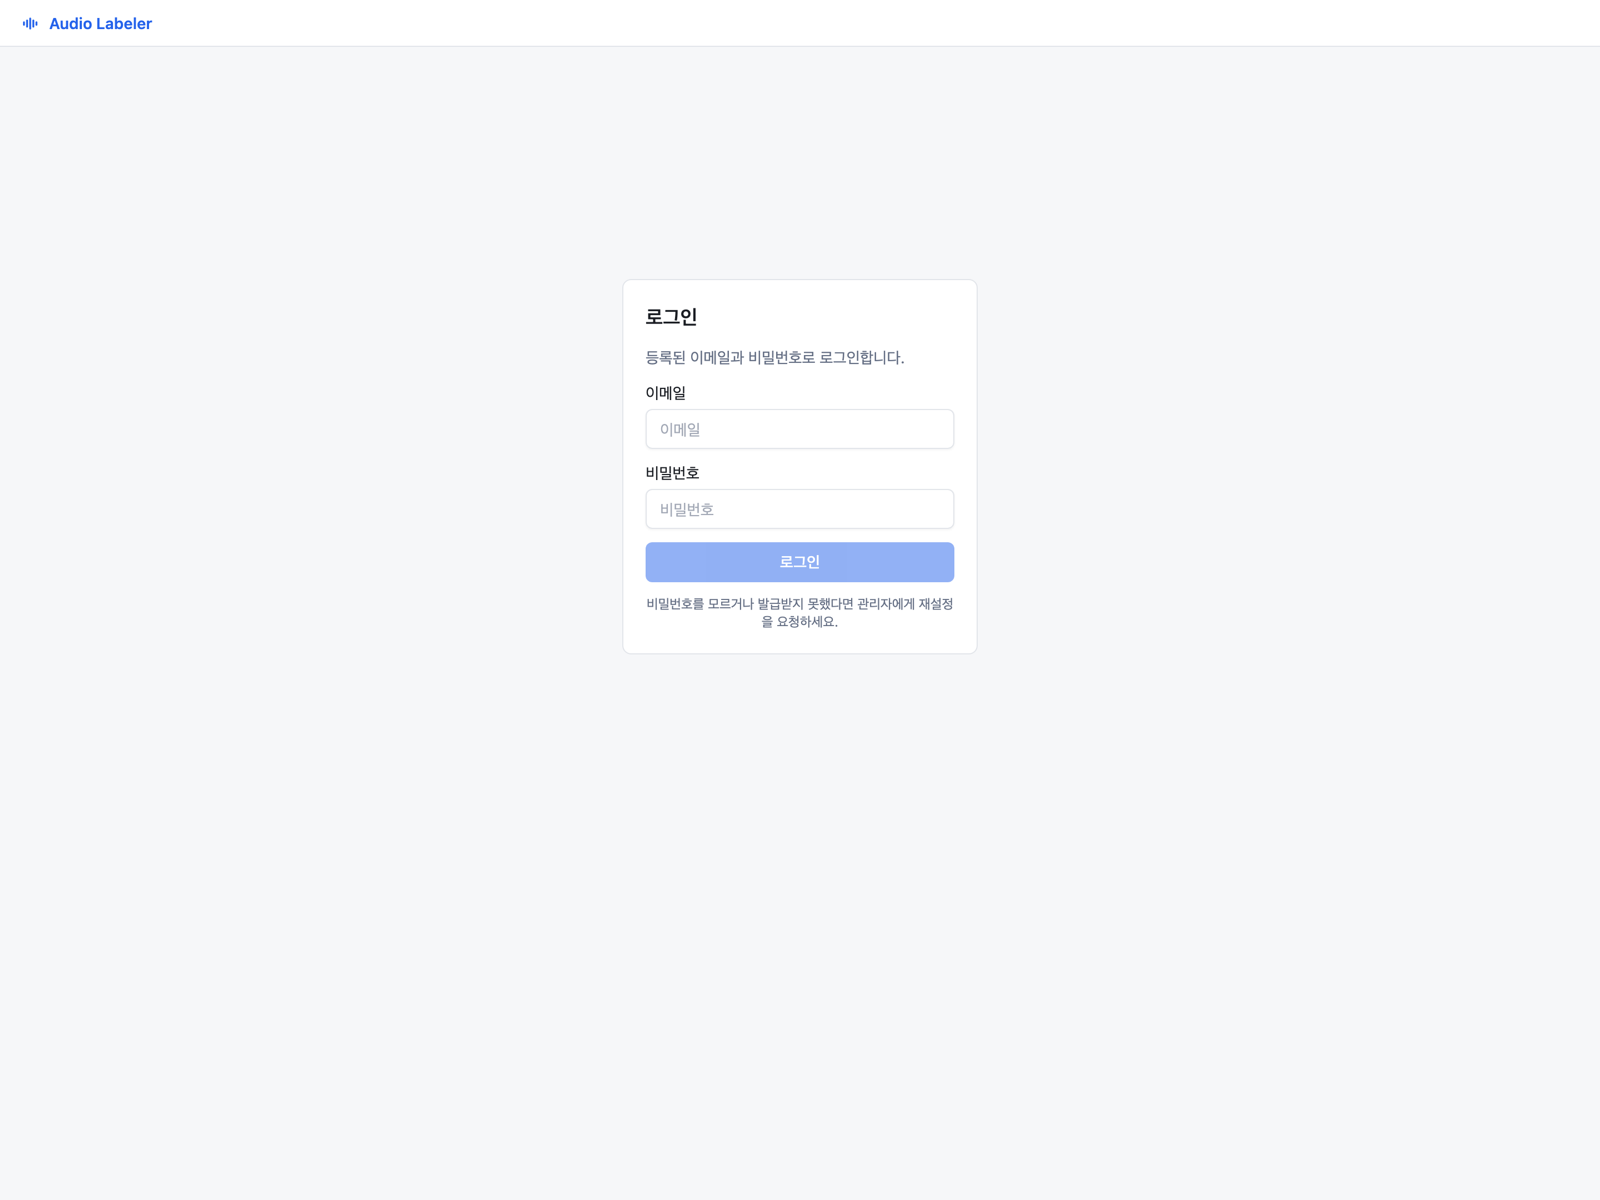
네 부분입니다. 팀이 전사를 고치고 학습 데이터를 만드는 사람 검수 플랫폼. 회사 GPU에서 서빙되는, 화자 분리가 붙은 파인튜닝 음성 모델. 인식된 용어를 엔진에 힌트로 되돌려 주는 56,000개 농업 용어 사전. 그리고 다른 모든 시스템이 부르는 게이트웨이: 배치 또는 스트리밍, 화자 라벨 유무 선택. 그 뒤에서 전사 결과가 보고서 코파일럿으로 흘러갑니다.
달라진 것
고객사의 실제 통화 2,354문장으로, 모든 엔진에 같은 채점 규칙을 적용해 측정했습니다. 우리 엔진: 글자 오류율 10.45%. 국내 1위 상용 음성 API: 16.39%. 출발점이었던 오픈소스 모델: 16.18%. 일상 대화에서는 상용 API와 같은 수준(7.16% 대 7.33%)이고, 공개 휴대전화 녹음에서는 앞섭니다(10.54% 대 11.56%). 업계에서 흔히 말하는 기준으로 20% 언저리는 “쓸 수 있지만 다시 확인”, 10% 언저리는 “믿을 수 있음”입니다. 고객사는 녹음된 통화의 약 1%만 라벨링하고 첫 번째 구간에서 두 번째 구간으로 옮겨 갔습니다.
- Qwen3-ASR
- pyannote
- vLLM
- FastAPI
- NestJS
- PostgreSQL
- S3
농업 기업 앱 안에서 운영 중인 AI 재배 상담
회사의 농업 기술 노하우(재배 지침, 과거 보고서, 컨설턴트 통화)가 농가 질문에 출처를 달아 답하고, 컨설턴트 대신 보고서 초안을 씁니다.
- 실제 서비스에서 운영 중 · 2026년 5월부터 전체 농가로 확대
- 답변은 출처를, 보고서는 통화 원문을 인용
- 아키텍처 지도 하나, 게이트웨이 하나로 저장소 16개를 정렬
100만 학습자의 에세이와 말하기 채점
영어 시험 연습 서비스에 에세이와 말하기 답변의 즉각적이고 일관된 점수가 필요했습니다. 사람 채점으로도, 호출당 과금하는 외부 서비스로도 감당할 수 없는 규모였습니다.
- 사용자 약 100만 명 · 60억 원+ 투자 유치를 뒷받침
- 자체 모델이 LLM 첨삭 파이프라인을 대체
- 자체 호스팅 음성인식이 호출당 과금하던 외부 비용을 대체