TestGlider (데이터뱅크)에듀테크 스타트업 · 사용자 약 100만 명2020–2023AI 연구원 겸 엔지니어, 모델부터 운영까지
100만 학습자의 에세이와 말하기 채점
자체 모델은 API를 따라잡은 것이 아닙니다. 운영 환경에서 API를 대체했습니다.
영어 시험 연습 서비스에 에세이와 말하기 답변의 즉각적이고 일관된 점수가 필요했습니다. 사람 채점으로도, 호출당 과금하는 외부 서비스로도 감당할 수 없는 규모였습니다.
사용자약 100만 명
뒷받침한 투자60억 원+ ($5M+)
운영 서비스4개, 스테이징·운영 CI/CD 분리
연구arXiv 2309.02740. 발표 당시 세계 최고 성능
필요했던 것
TOEFL·IELTS 학습자는 자기 에세이나 말하기 답변이 몇 점일지 지금 당장 알고 싶어 합니다. 사람 채점은 규모가 안 나오고, 답변마다 외부 서비스에 돈을 내는 것도 마찬가지입니다. 점수는 견고해야 했습니다. 엉터리 답변은 0점이어야 하고, 사용자가 보는 점수는 모델이 낸 점수와 같아야 합니다.
만든 것
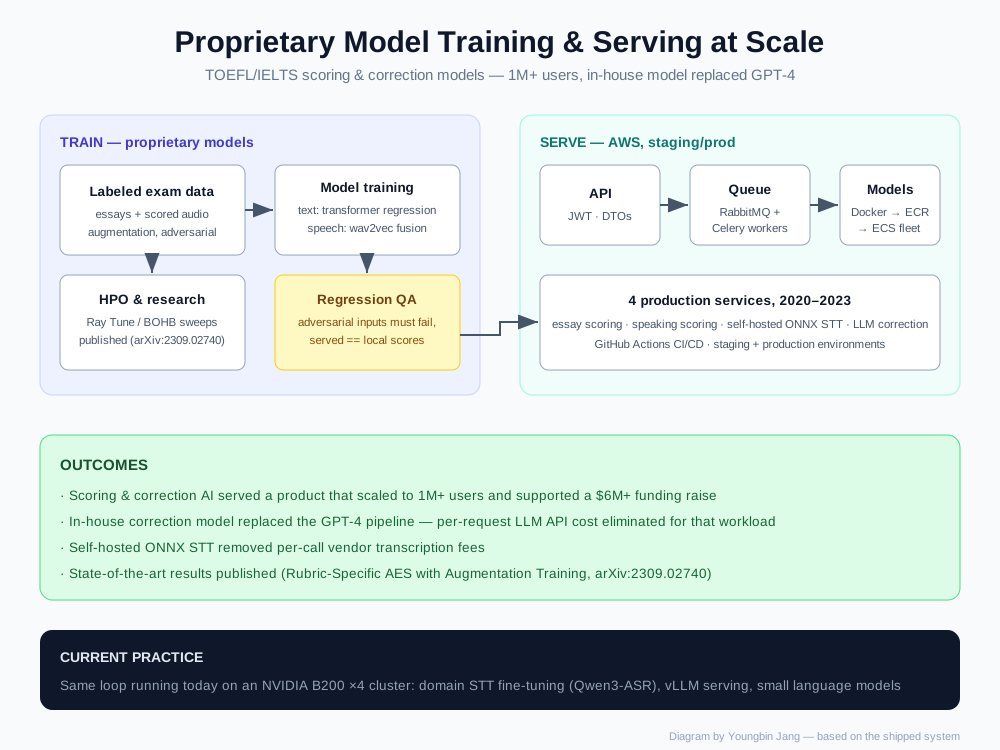
회사의 자체 에세이 채점 모델(그 뒤의 연구는 발표 당시 세계 최고 성능)과, 음성을 듣고 전사를 읽는 말하기 채점 모델. 나중에는 GPT-4 파이프라인을 대체한 자체 첨삭 모델과, 외부 비용을 대체한 자체 호스팅 음성인식 서비스. 네 가지 모두 AWS에서 운영 서비스로 돌아갔고, 배포마다 실제 모델을 검사하는 테스트 하네스가 있었습니다.
달라진 것
회사가 소유한 모델 위에서 서비스가 약 100만 명 규모로 성장했고, AI는 60억 원 이상 투자 유치의 핵심이었습니다.
기술적으로는
에세이 채점: 루브릭별 헤드가 있는 트랜스포머 회귀, 적대적 학습과 증강(arXiv:2309.02740). 말하기: wav2vec 음성 특징과 텍스트를 결합.
서빙: Flask/uwsgi + Celery·RabbitMQ 워커, Docker → ECR → ECS, 스테이징과 운영 파이프라인 분리. 음성인식은 비용 때문에 ONNX Runtime으로 이식.
하네스: 배포 시 실제 모델 검사. 엉터리 답변은 0점이어야 하고, 서빙 점수는 로컬 추론과 일치해야 함.
부수 작업: 같은 제품군을 위한 TypeScript RAG 애플리케이션(NestJS, 벡터 + 키워드 하이브리드 검색, React).